
"La IA no puede conocer aquello que no existe en los datos a los que tiene acceso"
Entrevista a Adrià Cortès, CEO y fundador de Amphora
Laura Rodríguez Escosa
Periodista especializada en la producción de aceite de oliva y logística · Interempresas Media
28/09/2026
Periodista especializada en la producción de aceite de oliva y logística · Interempresas Media
28/09/2026
La búsqueda de datos consume tiempo y ralentiza la toma de decisiones. Amphora ha desarrollado una tecnología de IA que permite interactuar con los datos reales de la logística de un ecommerce a través de ChatGPT, Claude o Perplexity. Entramos en detalle con Adrià Cortès, CEO y fundador de Amphora.
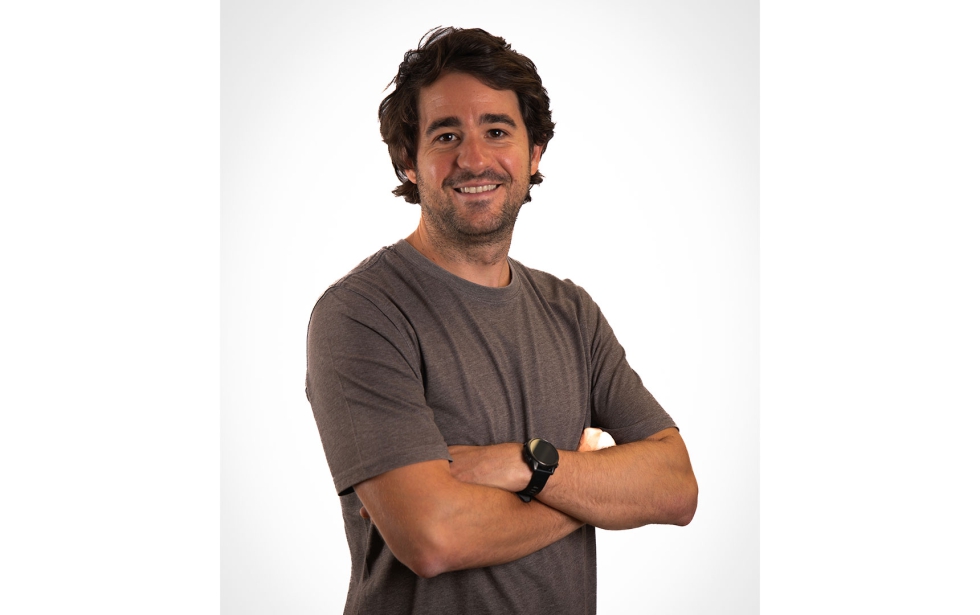
Adrià Cortès, CEO y fundador de Amphora.
¿Qué nivel de precisión puede ofrecer un modelo de IA generalista como ChatGPT o Claude cuando se utiliza para consultar una operativa logística compleja? ¿De qué depende la fiabilidad de sus respuestas?
La precisión no depende únicamente del modelo de IA, sino sobre todo de los datos y del contexto que es capaz de interpretar. En nuestro caso, la IA no responde sobre información genérica, sino que puede consultar los datos reales de la operación de Amphora y relacionarlos entre sí. Por eso, la fiabilidad depende tanto de la calidad de esos datos como de la capacidad del sistema para interpretarlos correctamente. La IA es tan fiable como la información y el contexto sobre los que trabaja.
¿Qué tareas concretas puede realizar actualmente la IA y cuáles esperan incorporar en las siguientes fases? ¿Cómo puede modificar su uso la gestión diaria y los tiempos de una operación logística?
Actualmente estamos centrados en facilitar la consulta de información real de la operación: pedidos, stock, devoluciones, entradas de mercancía, entregas, incidencias o facturación. El siguiente paso es incorporar informes personalizados, asistencia contextual, recomendaciones y automatizaciones como la corrección de direcciones o la gestión de tickets. El cambio más importante es que el usuario deja de invertir tiempo en buscar, filtrar y cruzar información y puede dedicarlo directamente a entender qué está pasando y actuar.
Al convertir la consulta de datos en una conversación, ¿existe el riesgo de multiplicar consultas innecesarias o poco relevantes simplemente porque obtener una respuesta resulta inmediato? ¿Cómo puede evitarse que la facilidad de uso genere ruido en lugar de mejorar la toma de decisiones?
Sí, es un riesgo que existe con cualquier nueva interfaz que haga más fácil acceder a la información. Pero nuestro objetivo no es conseguir que los usuarios hagan más consultas, sino que necesiten menos tiempo para obtener la información que realmente necesitan. La conversación debe servir para eliminar fricción, no para generar más ruido. Por eso creemos que el valor estará en la capacidad de la IA para aportar contexto y ayudar a interpretar los datos, no simplemente en responder preguntas.
¿Qué indicadores o mecanismos de validación utilizan para comprobar que las respuestas de la IA son correctas y que interpreta adecuadamente los datos de la plataforma? ¿Cómo detectan una respuesta errónea o una interpretación incorrecta?
Aquí hay un matiz importante según la fase en la que nos encontramos. Hoy, en la fase piloto, es el propio cliente quien aporta el asistente de IA: su Claude, su ChatGPT, y eso hace que sea complicado evaluar si una respuesta concreta es correcta o no, porque no tenemos acceso a esas conversaciones, solo a las preguntas que la IA hace a nuestro sistema.
Sin embargo, el MCP que exponemos a los clientes es exactamente el mismo que usamos internamente, y ahí sí tenemos visibilidad completa: no solo de las preguntas, sino también del razonamiento que sigue la IA para responder. Ese razonamiento nos permite tener otros modelos de IA revisando qué se ha podido interpretar mal, y genera avisos para mejorar la documentación cuando detectamos ambigüedad.
¿Puede el propio sistema detectar que una consulta está mal planteada, que faltan datos para responderla o que el usuario está intentando utilizar la herramienta para una función para la que no está diseñada? ¿Qué hace en esos casos?
Es una capacidad que queremos seguir desarrollando a medida que ampliemos el producto. No queremos que la IA simplemente genere una respuesta ante cualquier pregunta, sino que sea capaz de trabajar dentro del contexto y de las capacidades reales de Amphora. Aquí también aplica el matiz de la fase actual: cuando es el cliente quien usa su propio asistente, no tenemos acceso a la conversación completa, solo a las preguntas que le llegan a nuestro sistema, así que es difícil evaluar en tiempo real si ha detectado bien esas situaciones.
Como esa capa de contexto es la misma para todos, cada mejora se traduce en un sistema que sabe cada vez mejor cuándo no tiene información suficiente para responder.
Afirmáis que el objetivo no es construir simplemente un chatbot. Desde el punto de vista técnico y operativo, ¿qué diferencia esta herramienta de un chatbot conectado a las bases de datos de una empresa?
Un chatbot conectado a una base de datos puede ayudarte a recuperar información. Nosotros queremos ir un paso más allá: que la IA entienda el contexto de una operación logística, sea capaz de relacionar diferentes datos y, progresivamente, pueda ayudar a interpretar lo que está ocurriendo y actuar sobre ello. El MCP nos permite conectar los modelos de IA con las herramientas y fuentes de información de Amphora. Por eso hablamos de hacer que nuestro producto sea más inteligente, no simplemente de añadirle un chatbot.
Y esto es solo el primer paso. Es cierto que con el MCP se puede construir algo parecido a un chatbot como preguntar cuánto stock queda de un producto, pero las posibilidades van mucho más allá: nos permite crear agentes, sistemas independientes capaces de tomar decisiones y automatizar procesos sin que nadie tenga que preguntarles nada. Por ejemplo, que cada vez que el stock de un producto baje de una cantidad determinada, se envíe automáticamente un aviso al proveedor. Eso ya no es un chatbot, es un sistema autónomo e inteligente, y es posible precisamente gracias al MCP.
La calidad de la respuesta depende necesariamente de los datos disponibles. ¿Qué ocurre cuando faltan datos relevantes, existen errores de integración entre sistemas o una incidencia todavía no se ha registrado? ¿Puede la IA identificar que no dispone de información suficiente para ofrecer una respuesta fiable?
La IA no puede conocer aquello que no existe en los datos a los que tiene acceso. Si una incidencia todavía no se ha registrado, por ejemplo, no podemos esperar que el sistema conozca ese hecho. Por eso la calidad de los datos y la forma en que están estructurados son fundamentales. Nuestra prioridad es que la IA trabaje sobre información real y disponible y, sobre todo, evitar que genere una falsa sensación de certeza cuando los datos no permiten responder de forma fiable.
La herramienta no solo pretende consultar información, sino avanzar hacia recomendaciones y automatización de procesos. ¿Dónde sitúan la frontera entre informar al operador, recomendar una acción y ejecutar una decisión de forma autónoma?
Lo vemos como una evolución en tres etapas. Primero, que la IA pueda informar de lo que está ocurriendo; después, que sea capaz de aportar contexto y recomendar acciones; y finalmente, que pueda automatizar determinados procesos. Para gestionar esa frontera trabajamos con dos paradigmas: human in the loop y human on the loop. Esto significa que la IA tiene categorizadas las acciones que puede llevar a cabo: si detecta que hay que cancelar un pedido, no lo hará por su cuenta, enviará una solicitud al operador correspondiente pidiendo permiso. Si, tras una investigación, considera que hay que actualizar una dirección, podrá hacerlo, pero notificando a un agente, y así con cada tipo de acción disponible.
Todo esto lo estamos probando ahora mismo para poder implementarlo en un entorno real en un futuro próximo; en esta primera fase seguimos centrados en que pueda informar con precisión de cualquier situación. Ya estamos trabajando en casos concretos como la corrección de direcciones o la gestión de tickets, pero queremos avanzar de forma progresiva y controlada. La idea no es sustituir al operador, sino liberar a los equipos de tareas repetitivas y permitirles centrarse en las decisiones que realmente requieren criterio humano.
REVISTAS
Manutención y Almacenaje
Más de 50 años impulsando el sector. 360º alrededor de la cadena de valor logística